

Canva presentó su primer modelo de inteligencia artificial (IA) para generar imágenes con una resolución de hasta 2K y más de 30 relaciones de aspecto. La herramienta, llamada Craft, fue desarrollada y entrenada desde cero por el laboratorio interno de investigación de la compañía, que ahora se posiciona como el segundo más avanzado del mundo en generación de imágenes, según las clasificaciones de DesignArena.
La empresa señala que su nuevo modelo de IA es resultado de “años de investigación e inversión para ofrecer una comprensión más profunda del diseño, resultados que se ajustan mejor a lo que imaginaste y la libertad de editar y refinar fácilmente todo lo que creas”.

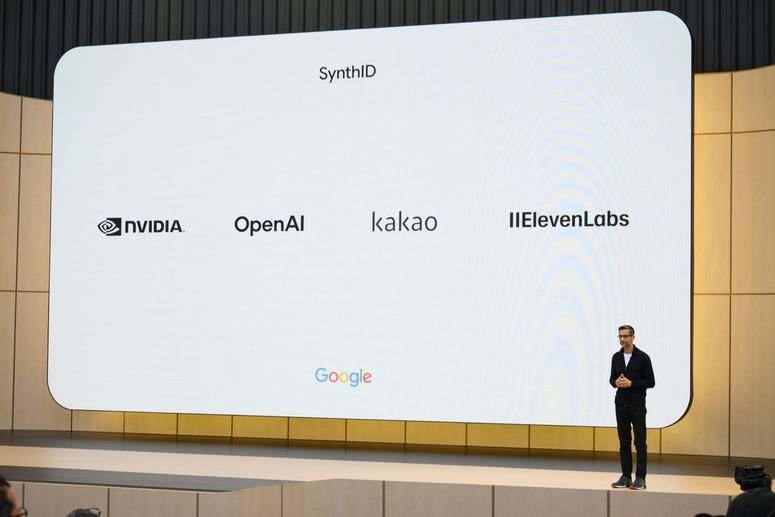
SynthID Detector de Google permite comprobar si una imagen, un video o un audio contiene la marca de agua utilizada por modelos de inteligencia artificial compatibles.
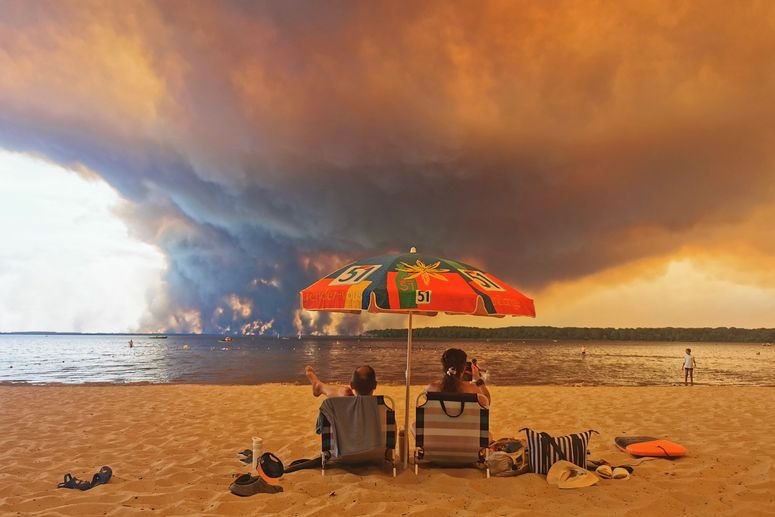
En la práctica, Craft permite generar imágenes fotorrealistas que combinan detalles, profundidad y transiciones suaves con principios de composición propios del diseño, como la alineación, el espaciado, los bordes definidos y la ubicación precisa de los textos. Además, el sistema procesa indicaciones en “cualquier idioma” y puede incorporar texto en las imágenes en 55 lenguas.
Canva asegura que estas características permiten utilizar la herramienta de manera intuitiva, tanto a profesionales como a personas sin experiencia, para obtener resultados de alta calidad y fidelidad. Entre los materiales que pueden crear se encuentran anuncios, carteles, folletos, presentaciones, fotografías, publicaciones para redes sociales, ilustraciones, arte digital, retratos, escenas con varias personas, paisajes y composiciones conceptuales que combinan elementos realistas y estilizados.
Creación de imágenes en dos etapas
Una de las principales características que distingue a Craft de otros modelos similares es su arquitectura de dos etapas, que le permite analizar las solicitudes de los usuarios y diseñar un plan de composición antes de producir la imagen definitiva.
En la primera fase, el modelo utiliza un algoritmo secundario para identificar los elementos que debe incluir, sus posiciones y tamaños relativos, las relaciones espaciales entre ellos, la jerarquía visual y los textos que deben incorporarse. Durante la segunda etapa, otro modelo especializado en renderizado convierte ese esquema en una imagen de alta fidelidad y resolución.
El equipo de desarrollo asegura que “al modelar explícitamente la composición y la tipografía antes de renderizar la imagen final, Craft puede generar diseños complejos con mayor precisión, incluyendo texto legible, colocación precisa de objetos y relaciones visuales coherentes. Esta arquitectura también permite un control más detallado sobre los elementos individuales, facilitando cambios específicos sin alterar innecesariamente el resto”.
La compañía afirma que esta plataforma constituye la base técnica para desarrollar futuras funciones de edición avanzada, centradas en la incorporación de imágenes de referencia, que podrían integrarse en próximas versiones de Craft.
Los desarrolladores destacan que el proceso de entrenamiento fue determinante para alcanzar las capacidades del nuevo modelo. Según explican, los datos utilizados incluyeron “millones de plantillas creadas por humanos de la biblioteca de contenido”. A partir de estos ejemplos, Craft aprendió cómo se relacionan la distribución de los elementos, la jerarquía visual, el espaciado y la tipografía, en lugar de limitarse a reconocer la apariencia de una imagen terminada.